Golang基础(二):变量与数据类型
变量声明
golang变量以关键字var开头,变量名放中间,变量类型声明后置:
var 变量名 变量类型
123var name stringvar num intvar isok bool
为了简化掉var,还支持批量变量声明:
123456var( a string b int c bool d float32)
变量赋值
和C++类似,变量声明会进行默认初始化,例如整型和浮点型默认为0,字符串类型默认为空字符串,布尔型默认为false,切片/函数/指针变量默认为nil。
同样可以在声明时通过表达式赋值: 12var name string = "EdemMo"var age int = 18
编译器还支持自动的类型推导,省略类型声明,甚至一个等式声明多种变量:
1234var name = "Eden"var age = 18var name,age = "Eden", 18 //ok
函数变量
全局变量使用上述方式进行声明,如果是函数内部的局部变量,无需var ...
Golang基础(一):环境部署与Hello World
Go语言概述
Golang创自2007年,由谷歌于2009年正式开源的一门计算机高级语言,其由C系语言改进而来,自开源以来便得到许多为人津津乐道的赞赏:天然支持高并发、跨平台、简单易用、性能高,其生态社区也逐渐完善,其设计哲学非常简单,直接丢弃了C++三大面向对象特性——类封装、继承和多态,泛型(1.18,2022年)是后面才引入的。
当然,Go在国内市场仍然是一款高度业务化的语言,多用于设计微服务和高并发,可玩性(可折腾性)比不上python和C/C++,这也是其设计哲学的体现,从底层而言其不提供手动内存管理而使用自动gc,不适用于内核开发;从应用层而言其更多专注后端服务,对Gui支持较差,就业市场也比较狭窄,尤其AI时代下使用其他语言去造轮子成本更低,使得Go并不那么需要被迫切普及。
但尝试新东西总会有新的启发,golang仍然是其中较为值得学习的语言之一。
windows 11安装和VsCode编译
go的安装比较简单,在网址下载msi安装,或下载压缩包(如go1.27.1.windows-amd64.zip,注意要x86-64架构的),解压并且设置环境变量即可,以下下 ...
C++ 23 新特性总结(一):Deducing this与CRTP模式
C++ 23新特性:Deducing
this(this推断特性)
Deducing this是来自Gašper
Ažman 、 Sy Brand 、
Ben Deane 和 Barry
Revzin的提案,他们希望用一种新的方式来推断成员函数中被调用表达式值的类别,也即从成员函数内部,判断它调用的表达式的cv特性和左右值类型等。
目前看来有三大用处:
在匿名函数中简单的实现递归:这就是在此前文章中描述的;
替代过多左右值重载函数的实现;
简化CRTP模式的实现;
完整提案见Deducing
this。
重载函数deducing
在Scott Meyers的《Effective C++》中(见读书笔记:Effective
C++(第三版))中提到,C++
03允许成员函数拥有cv限定符,某个类中需要同一个成员的const和non-const重载,但他们的实现是基本一样的,这种情况要么写相同的代码,要么类似Scott
Meyers那样采用委托的方式,让一个重载依赖于另一个重载的实现:
1234567891011class TextBlock ...
C++实现匿名函数递归:std::function、Y Combinator and Deducing This
这周写到递归的快速排序时突然发现:我不懂如何去用匿名函数去递归自身,因为正常的lambda就不支持:
12345678910//this is a wrong code phasestd::vector<int> nums{9,5,2,7,1,2,3};auto quick_sort = [&nums](int low, int high){ if(low < high){ int pivot = sort_paticial(low,high); quick_sort(low, pivot-1); quick_sort(pivot+1, high); //wrong }};
当然C++委员会也意识到这个问题,在C++
11我们有std::function,C++
14有Y组合子,C++
23有Deducing this,籍此机会详细记录一下。
方案1(C++11):std::function封装
对大部分编译器匿名函数不支持在捕获列 ...
数值分析方法:C++的工程实现
《数值分析方法》想来是不少工科研究生的必修课程,最近发现不少工程问题的初始推导都来自数值分析的一些方法,全面梳理其中的算法和结论推导是想做很久的事情之一,虽然很耗时间,但是并不是什么很困难的事情(对比此前各种的Labs),毕竟教会一个engineer如何做researching,比教会一个reseacher如何做好engineering要来得简单(然而很多reseacher乐意去做engineering,但engineer有机会且沉下心做reseach的少之又少)。这本书更是有很多适合工程化的算法,因此本文会基于原教材的编排和定理结论,尤其注重结论的证明和相关算法demo的C++实现,提供:
数值分析的基本思想方法和手段。
遵循数理的结论推导与证明。
开箱即用的各种C++算法。
适量的数值优化/最优化理论拓展;
第一章:数值分析与科学计算引论
误差定性与分析
误差分类
模型误差:建立的数学模型和实际问题之间出现的误差,称为模型误差;只有简化和抽象问题时合理才能得到较好的结果,这种误差不在数值分析的讨论中,同时要衡量这种误差有时候需要根据观测物理量,如温度、电 ...
快速方差更新算法:Welford Online算法
方差Two Pass算法
最近在数据处理中验证数据时发现细小的理论偏差,排查后发现是数据的方差更新方法出现了错误,起源是想优化这么一组函数:
123456789101112auto calculateVariance = [](const std::deque<int>& data){ if(data.empty()){ return 0; } int mean = std::accumulate(data.begin(), data.end(), 0)/data.size(); double sum_sq_diff = 0.0f; for(const auto& pos : data){ int diff = pos - mean; sum_sq_diff += diff*diff; } return (int)(sum_sq_diff/data.size());};
因为这个data时常需要更新,每次更新都要重算整组函数,于是想到缓存一下总数,但是却没有重新计算均值 ...
【zaver源码剖析】基于epoll的非阻塞Http Server
Zaver是一个来自十年前的http项目,全篇使用C语言编写,代码比较简单,是一个非工业级的轮子。最近回顾两年前的文章,发现有一些坑没有填完,比如计算机网络的应用层(http等),见计算机网络基础理论:自底向上方法,Linux底层API关于epoll使用也没有相关demo,见Linux操作系统:网络编程,zaver基本上线程池、日志、epoll都是类Nginx风格的最简封装,学习成本较低,但也比一般demo的架构更齐全,作为一个epoll小轮子补充是恰到好处的。
Forked项目地址:https://github.com/EdenMoxe/zaver
日志输出
若干宏即可实现标准错误输出: 1234567891011121314151617181920212223242526272829#ifndef DBG_H#define DBG_H#include <stdio.h>#include <errno.h>#include <string.h>#include <stdlib.h>#ifdef NDEBUG #define ...
(Private)基于PyQt设计加解密信息算法demo
103c704d716c2a6b4b59a60c7b698e01b2823da6a8219962b18b774f53fd1fb19bb2520a49ea39154eb50b6a7505cd8b24c6bcc0bef57e1e60b114165db7b9f3afe098c6e57f530f2e3969719e042ec9d5a8ec24ea978f71e805c4a9269770239f98e256ff71ac27561c49895efea405af8f344442b632342116fbd69cd9002a541becf08ea69bbf07b5900940dcb698b86750b23b58b46655f38d196693789fcfe0096069cbd721f488700d0c0b9ff1889279775fece640a5228fd0873a4a86d9ea53dd09e10802e97c50d24d9f187478da744ef6cd7e22c0c2d0c8b0ca0c218e094d1a3743b8fe2cdc2ad892b2f94999b63ae93166f9eda ...
访客统计Inject:Vercount替代Busuanzi
这周发现进入网站,刷新状态竟然持续了一分多钟,以为是新做完的Music页的特效显示太花里胡哨拖垮了加载,打开后台查看pending情况发现原来是不蒜子资源请求失败了,触发了一分钟的超时。
不蒜子那么多年来作为访客统计的利器,在近年缺点也渐渐显露,尤其是在网络方面,例如不能统计科学上网环境访问、高频的502失败等,而恰巧本站访客基本来自谷歌收录(某度、某狗引擎实在过度拉跨,在本站上线的三个月就被谷歌收录,对比向某度主动推送url后一个月后才收录,某度起大早赶晚集的行事作风的确声名在外,也籍着这个机会,不得不作出一些新尝试了。
查阅了一些博客,恰好有一个名为vercount比较新的项目对标不蒜子,而且兼容相同的span标签、支持全球CDN、ip访客计数实测比不蒜子还要精确,唯一不足的是这是个为爱发电的公益项目,可能不知道未来哪天就挂了。因此记录下这篇文章,希望更多的博客自建者考虑使用vercount替代busuanzi。
其目前支持span标签或者React框架:
项目地址:https://github.com/EvanNotFound/vercount
官方地址:https ...
读书笔记:Effective Modern C++
在读了大半本Effective
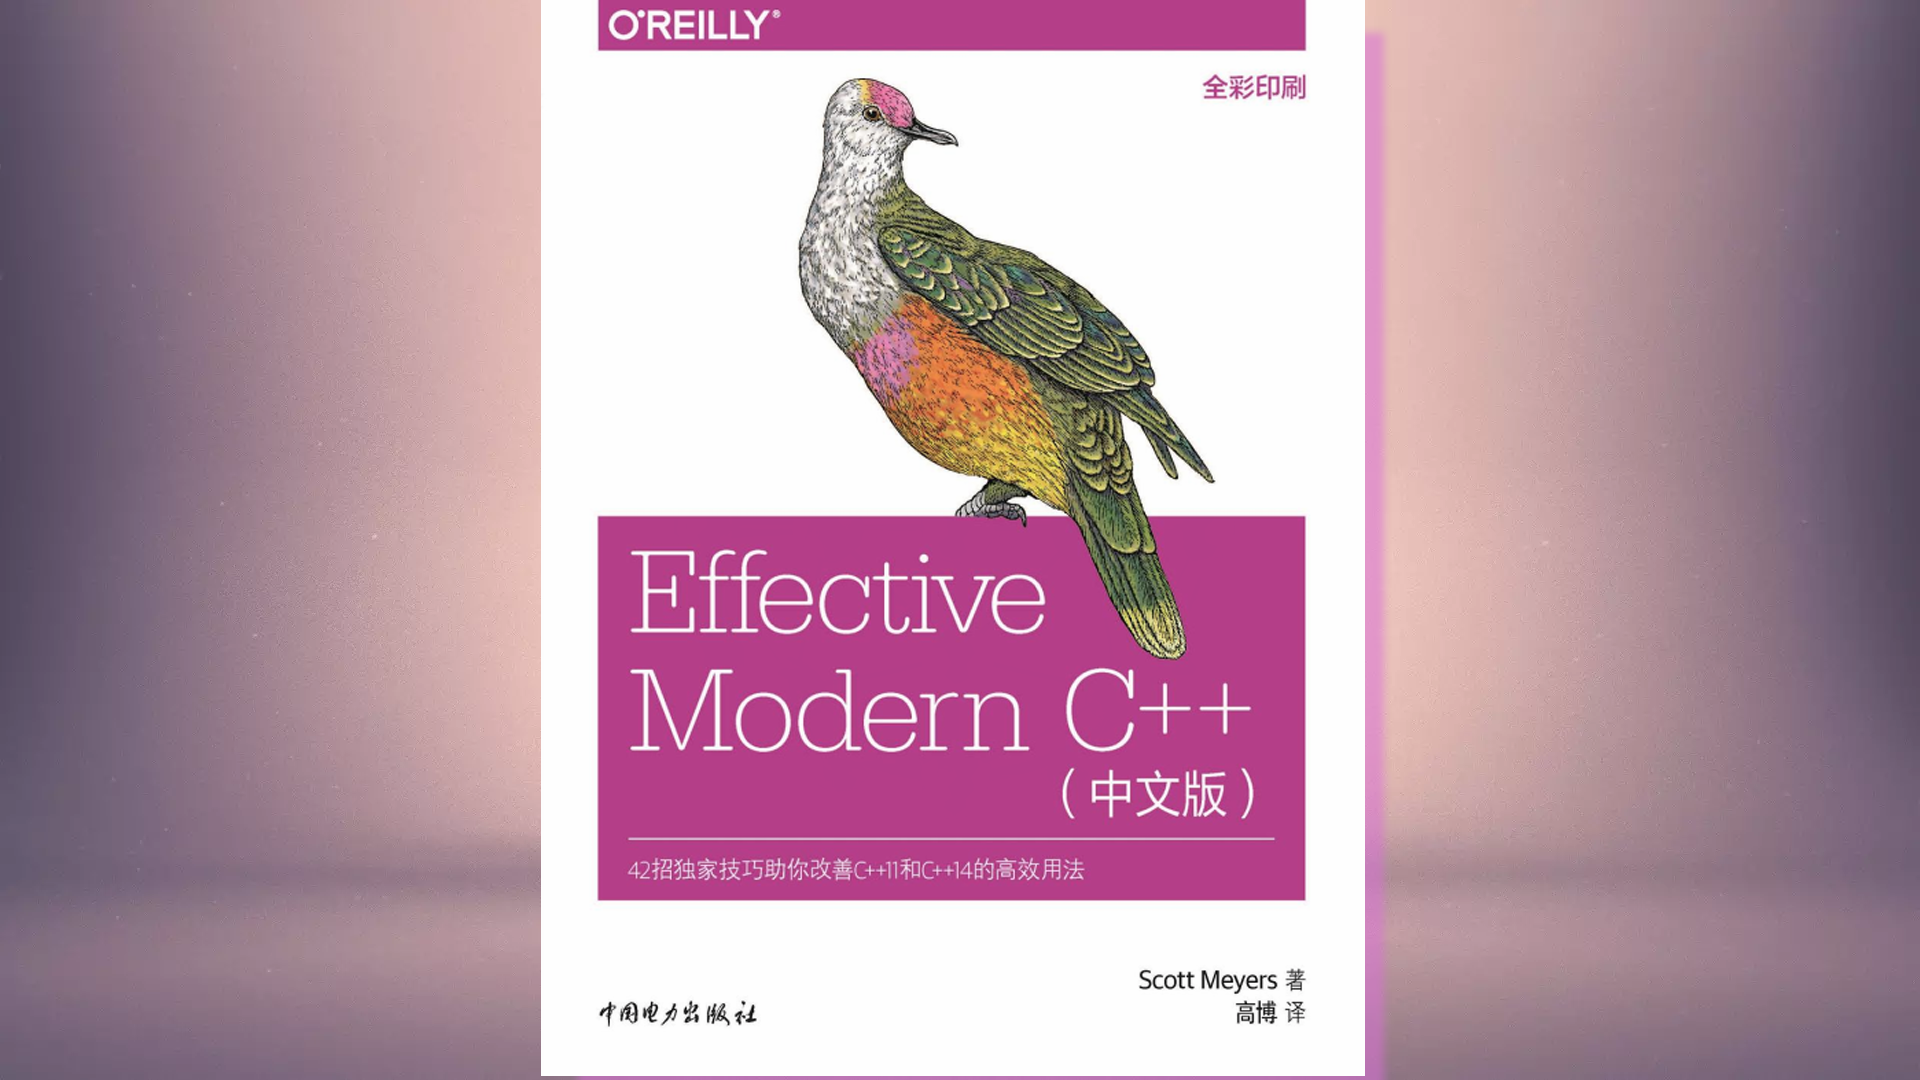
C++时,受益于其中许多代码规则,虽说不能让coding能力突飞猛进,至少你会开始对代码安全性有所思考,对任何开始接触C++具体项目的人,这都是一本首推的书。但对2025年的今天来说,仍然使用boost库的智能指针举例的00年代的书还是略显落后。庆幸的是,同作者Scott
Meyers也意识到这个问题,在10年前出版了包含C++ 11/14特性的《Effetive
Modern C++》,虽然C++
17/20甚至26已经开始进入快车道,但对大多数场景C++11和14的影响绝不能称为老旧。
译文项目来自EffectiveModernCpp_CN,持续更新。
第一章 类型推导
条款01:理解模板类型推导
决定读Effective Modern
C++的另外一个原因也来自条款一,大半年前我看了几篇模板编程和类型萃取的资料,写下了一篇文章:C++
Generic
Programming:SFINAF与类型萃取,其中有不少当时也不敢肯定的结论,完全是通过一些零碎的demo总结出来的,但竟然在这本书的第一章的第一节得到印证,缘分也好,伏笔也罢 ...